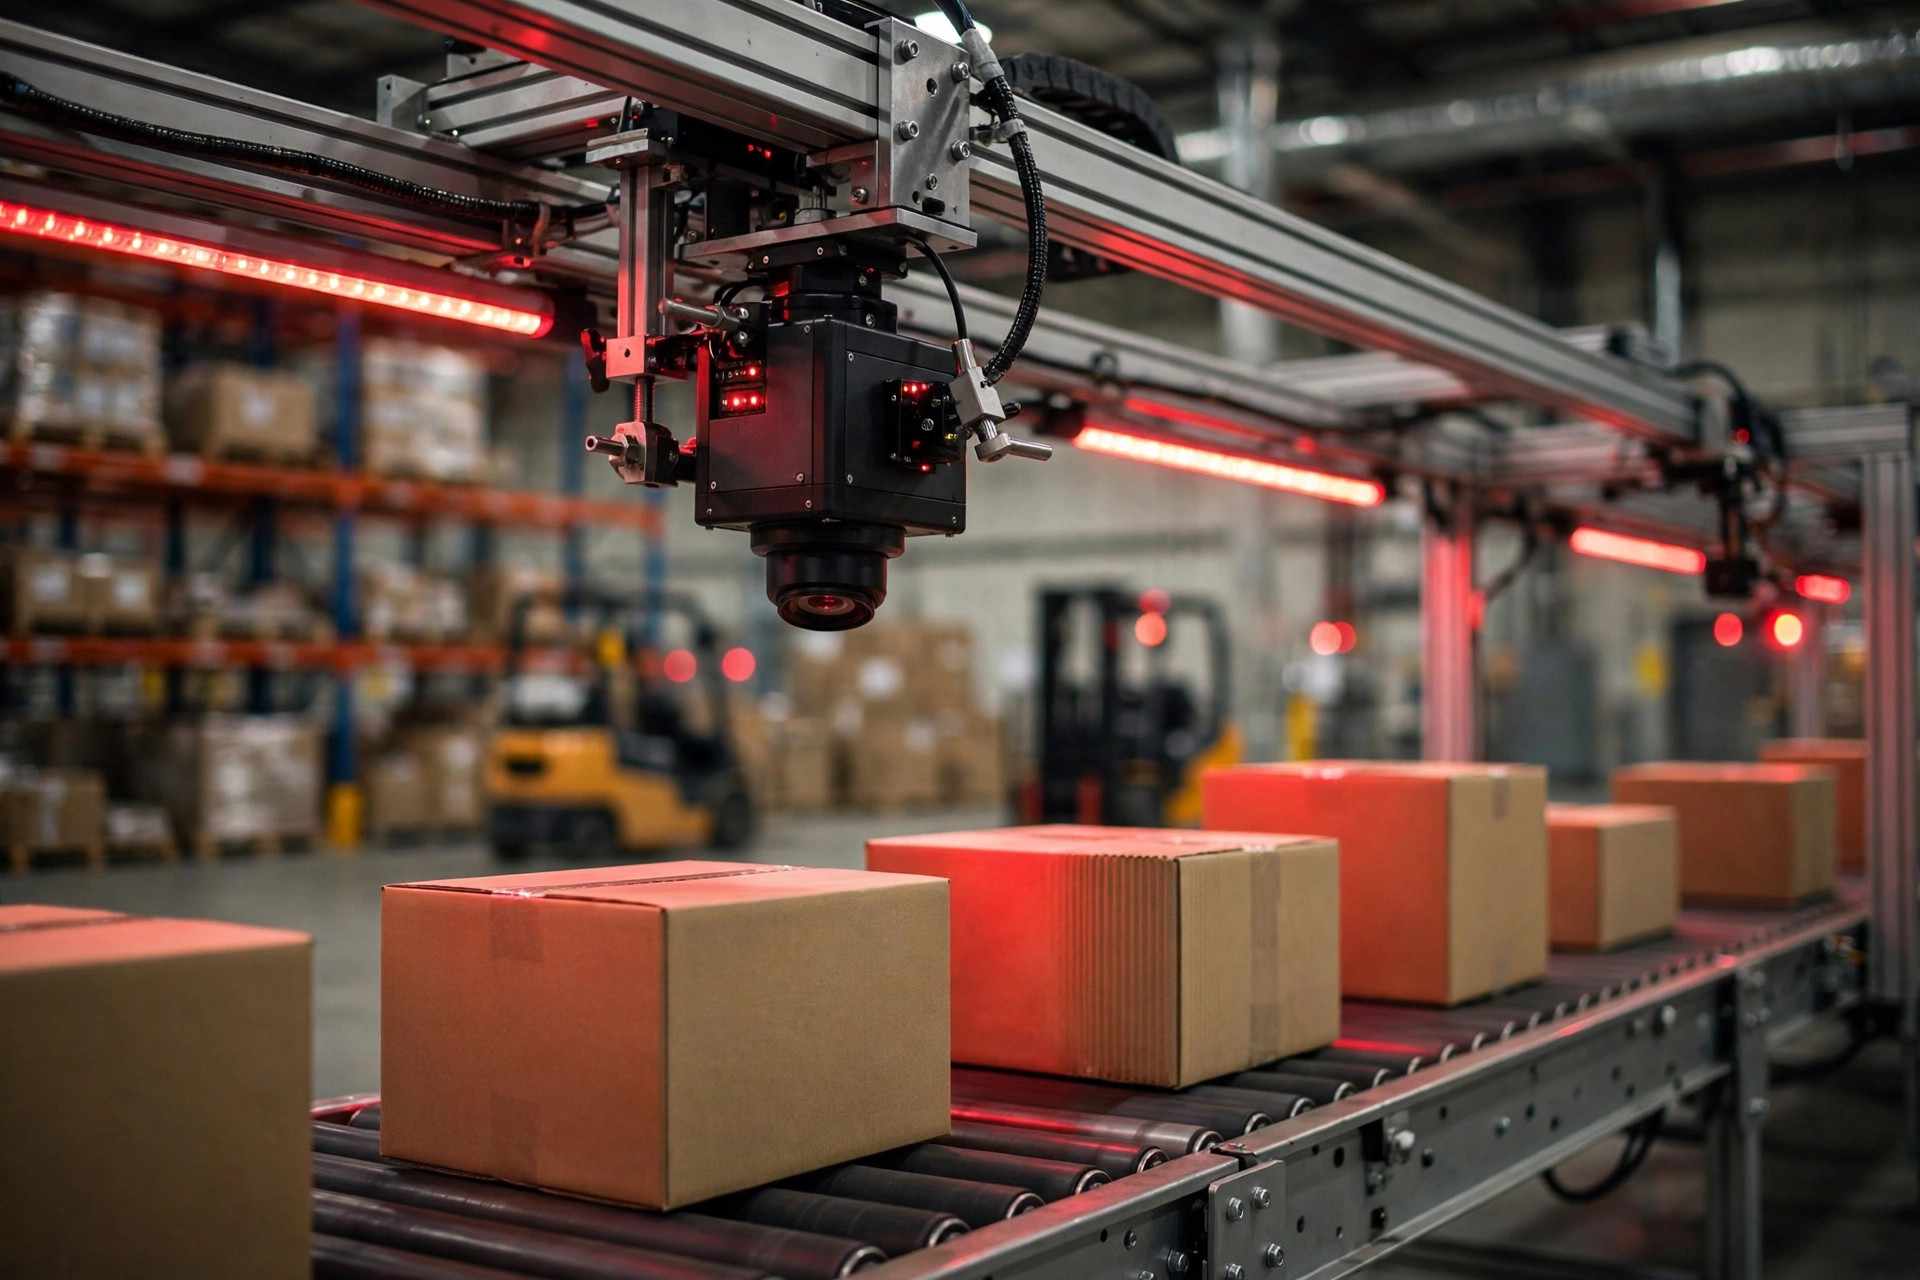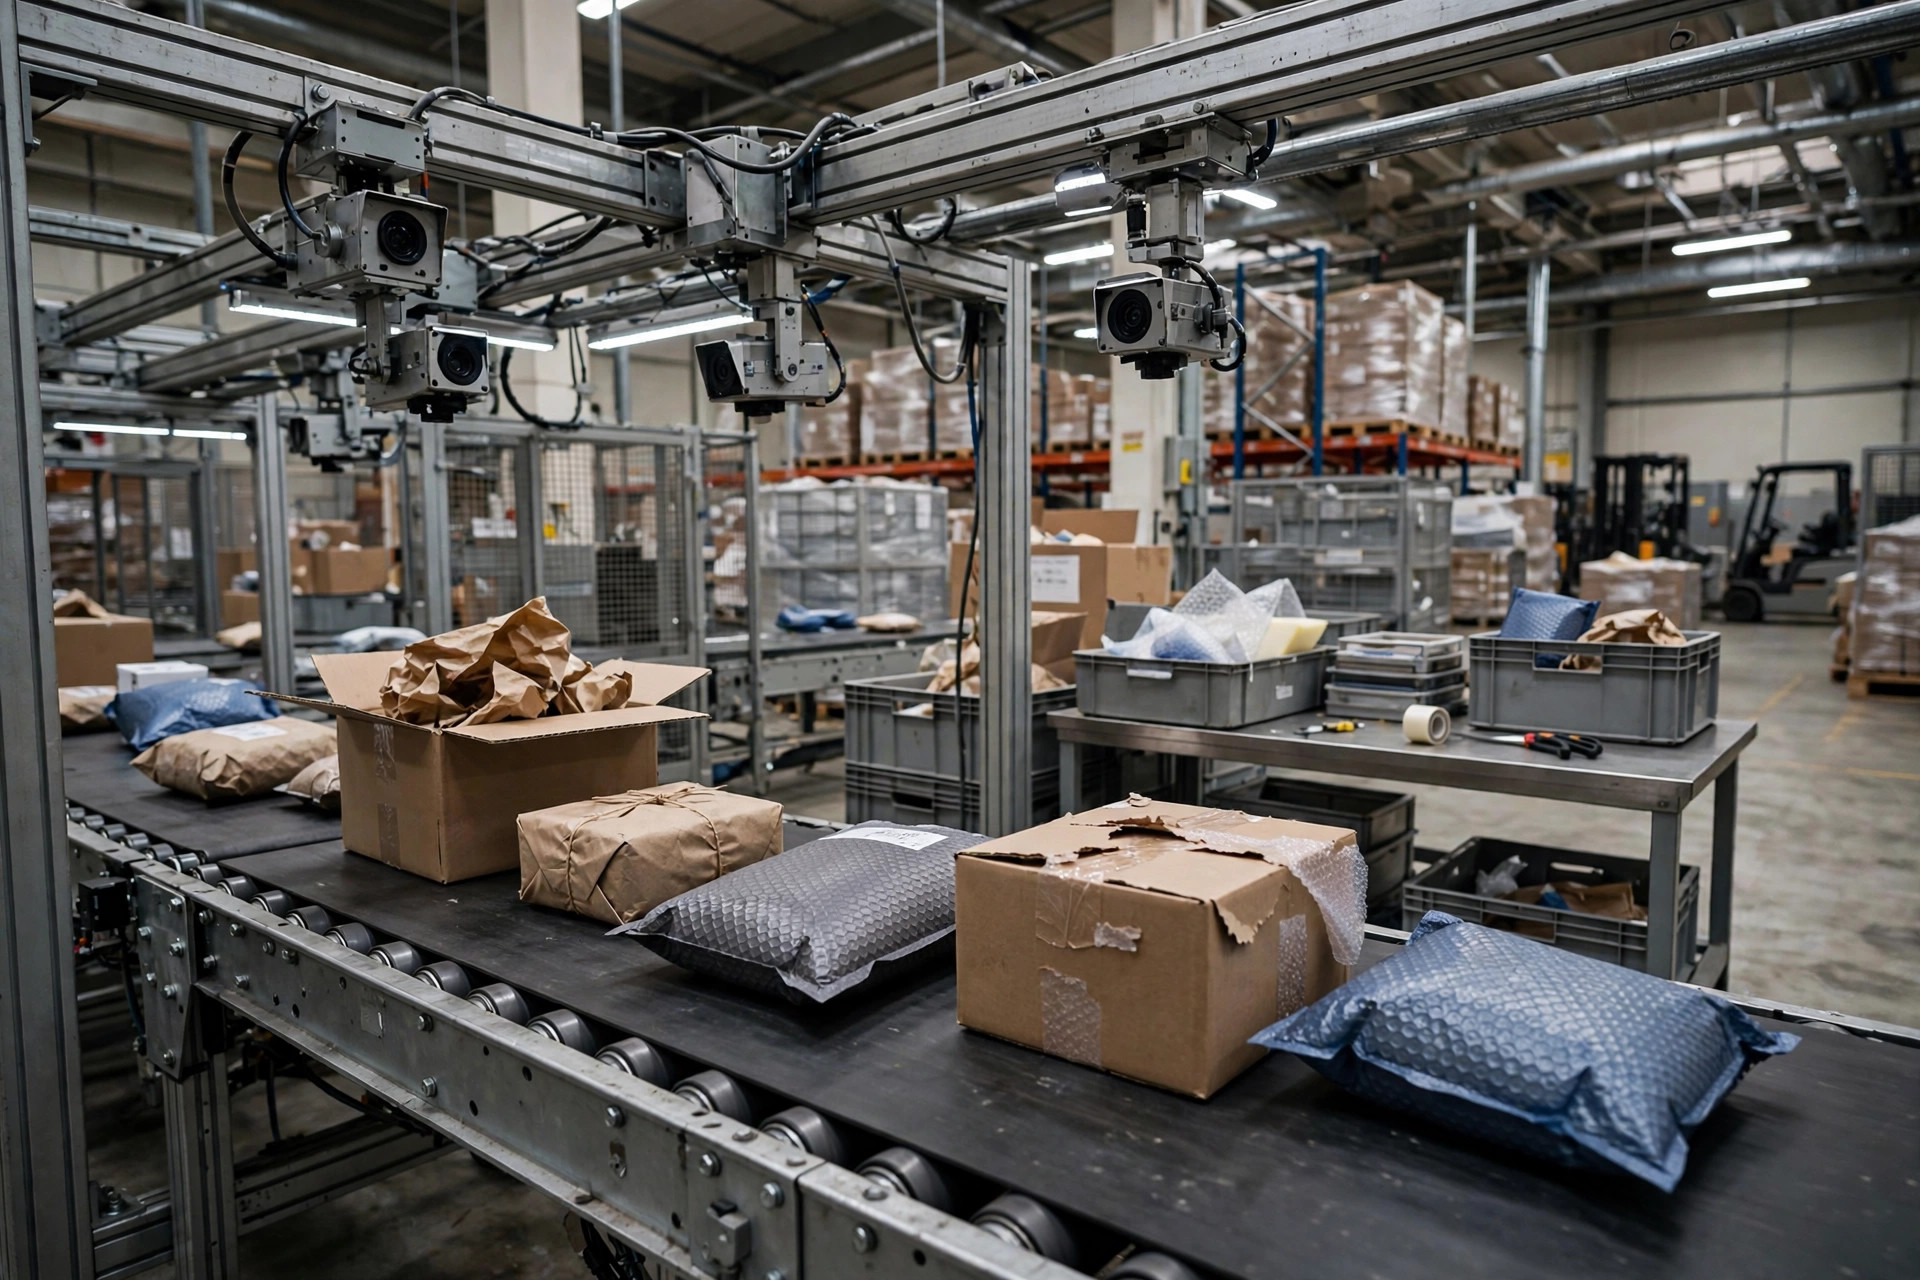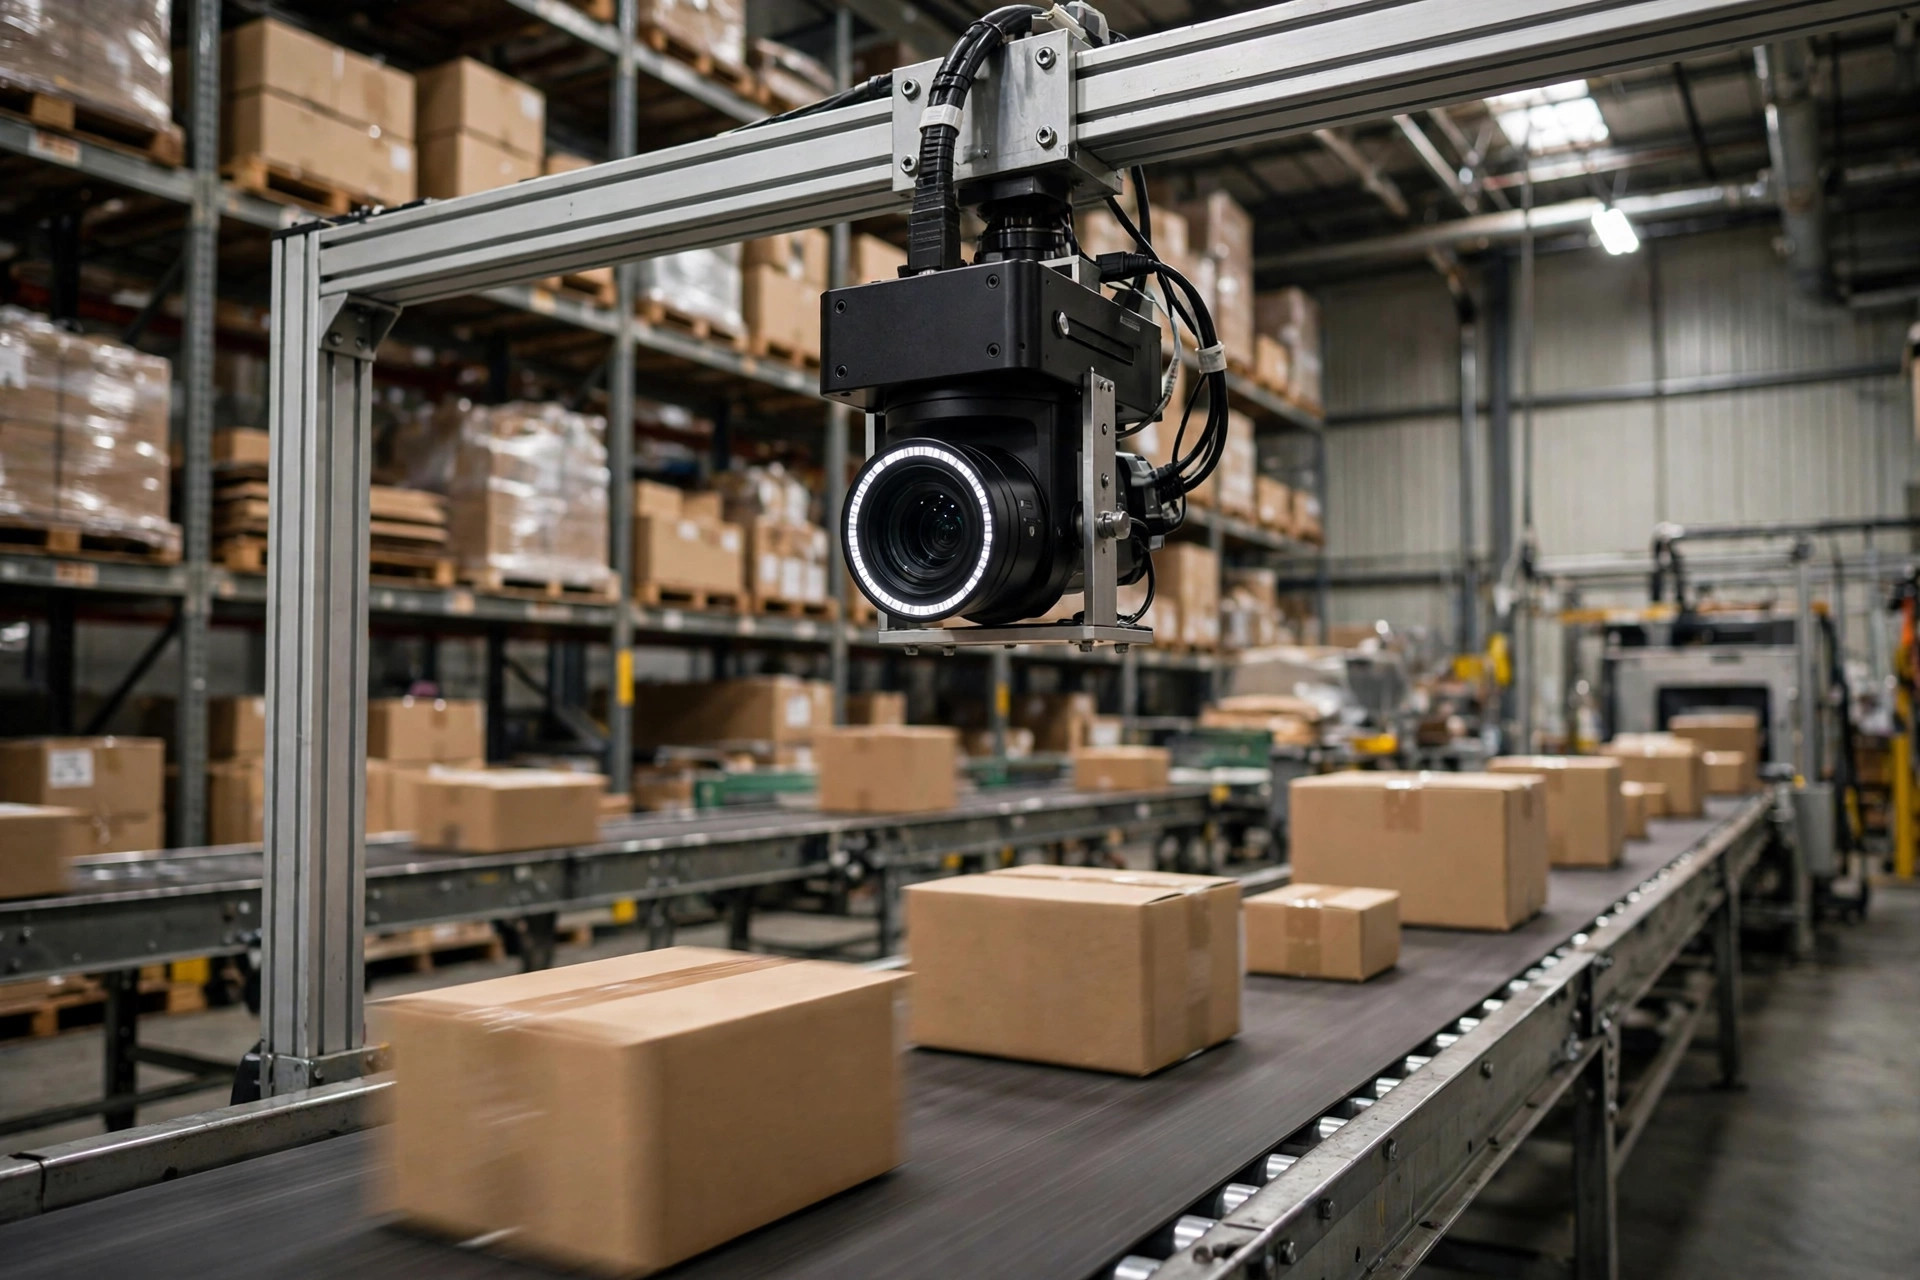
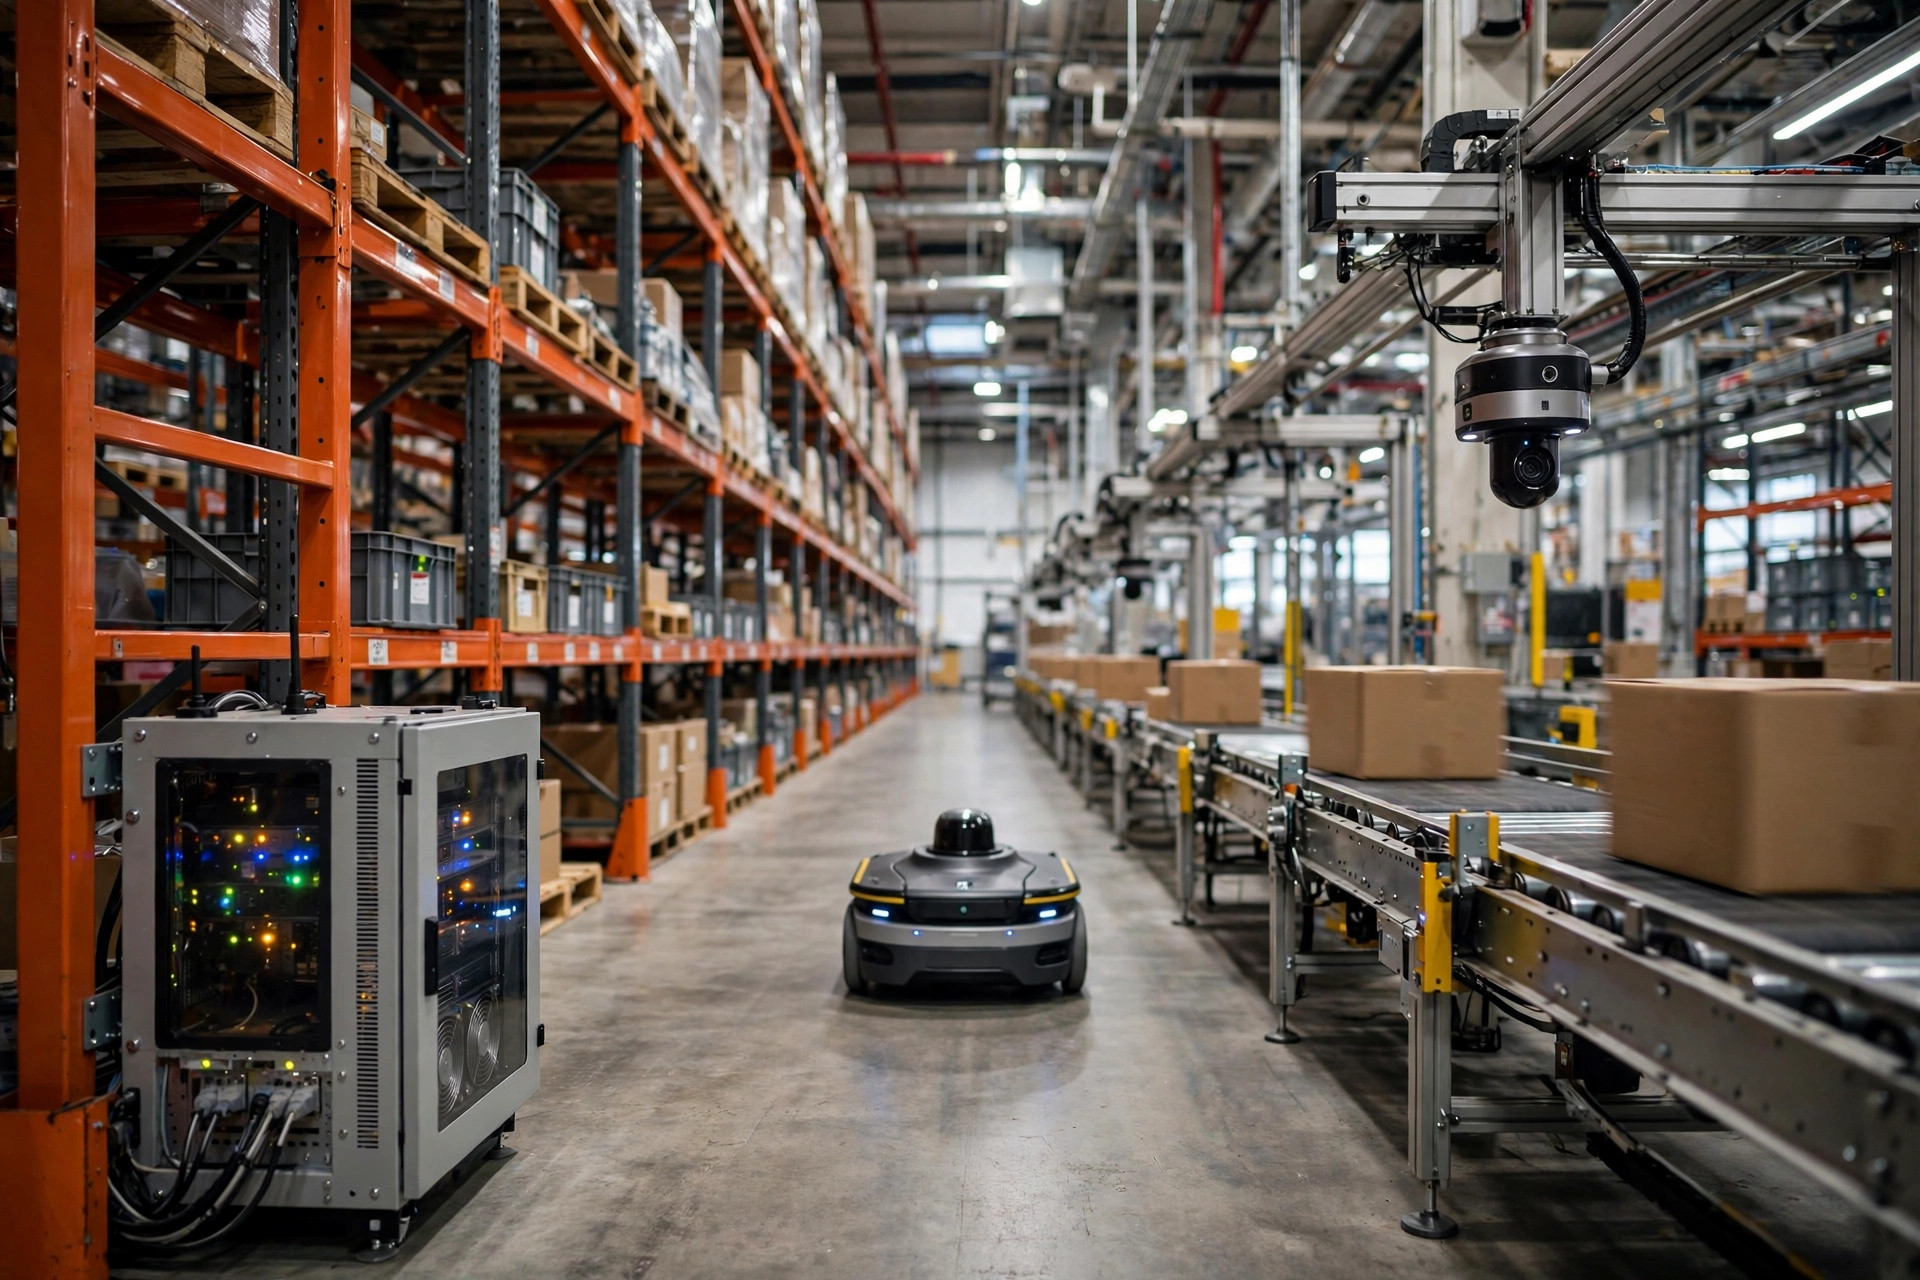
去年去了一家 Riverside 的电商仓,他们刚上了一套视觉检测:传送带上装了 6 台相机,拍包裹面单,识别破损和贴错的标签。方案是云端推理——视频流推到公有云,GPU 算完把结果打回来。结果上线第一周就出事:高峰期识别结果回来晚了半拍,剔除气缸没接到信号,十几个问题件直接流进了分拣格口。IT 负责人跟我说:"延迟这事,签合同前没人跟我提过。"
先说结论:仓库里的 AI 推理,10 毫秒和 300 毫秒的差距,不是体验问题,是能不能用的问题。部署在哪一层,决定了这套 AI 是生产力还是摆设。
先看延迟这笔账
相机拍一帧,送到云端、推理、结果返回,一个来回通常在 100~300 毫秒。这还只是网络好的时候。仓库的网络环境你懂的:金属货架就是天然的信号屏蔽器,Wi-Fi 死角到处都是,旺季网络一拥堵,延迟直接翻倍。
而边缘部署呢?一台装在机柜里的边缘盒子(带 GPU 算力的工控机),推理延迟一般在 10~50 毫秒。相机到盒子走的是局域网,甚至直连。
哪些场景必须边缘?我给你三条硬线:
第一,闭环控制。剔除、分拣、AMR 避障——凡是"AI 算完机器要立刻动"的场景,延迟超过 100 毫秒就别谈云端。传送带速度 2 米/秒,300 毫秒的延迟意味着包裹已经多跑了 0.6 米,剔除点都错过了。
第二,安全相关。人车混行的区域,AMR 的视觉避障要是走云端,等于把刹车交给了网络抖动。这种场景我直接判死刑:必须边缘。
第三,高频推理。单台相机每秒 30 帧,一天跑 16 小时,云端按调用次数或 GPU 小时计费,账单会吓你一跳。而边缘盒子是一次性投入,跑得越多越划算。
那云端适合干什么?训练、模型迭代、大屏看板、跨仓的数据汇总分析。这些不赶时间、要算力弹性的活,云端是主场。
带宽和钱:容易被忽略的大头
很多人算账只算 GPU 费用,漏了带宽。一台 1080p 的相机,H.264 编码后一路流大概 4~8 Mbps。50 台相机就是 200~400 Mbps 的持续上行。仓库的专线带宽多少钱一个月,你心里有数。更麻烦的是稳定性——专线一抖,所有相机的推理一起掉线。
边缘方案的带宽需求几乎为零:视频不出内网,只有推理结果(几 KB 的 JSON)和告警截图往上传。断网了也不怕,本地照样跑,最多是告警延迟上报。
钱的算法我帮你拆一下。云端是"按量付费",适合用量小、波动大的场景;边缘是"固定投入+折旧",适合 7×24 连续跑的场景。分界线很好算:把你一年的云端推理账单(GPU 费用+带宽+数据传输费)列出来,跟边缘盒子的采购+三年折旧+电费+运维比。我的经验是,超过 20 路相机连续推理,边缘基本稳赢。低于 10 路、且推理频率不高(比如一天只跑几小时的质检),云端更省事。
但有个坑:云端厂商的计费项比你想象的多——GPU 小时、存储、API 调用、数据传出费。签合同前把这四项都要到报价,拿不准的就写邮件让对方书面确认,别信销售口头说的"差不多"。
数据不出厂:容易被法务拦下的一关
还有一关很多人前期没想到:数据合规。相机拍的是仓库作业画面,里面有人脸(作业员)、有客户的货、有面单上的收件信息。视频流传到公有云,等于把这些数据交给了第三方。
美国这边,几个大客户的合同里已经开始写"作业视频不得出境、不得用于模型训练"的条款。欧洲更严,GDPR 下人脸是生物识别数据,处理要有依据。边缘方案天然占优:视频不出内网,合规评审好过得多。
我的做法是:方案评审阶段就把法务/客户合规要求拉进来,别等部署完了被叫停。需要过云端的场景(比如跨国公司的全球看板),传上去的只做脱敏后的结构化数据——"某条线误报率 3.2%"这种,而不是原始视频。
混合方案的落地顺序:别一上来就全仓铺
很多仓第一次上 AI 视觉,最大的错误是"全仓一起上"。我的建议是三步走:
第一步,单点试点。选一条最痛的线——比如退货质检或面单检测,只上 2~4 路相机,边缘盒子先跑起来。试点期 4~6 周,目标不是省多少钱,是把延迟、准确率、误报率三张表跑出来。误报率超过 5%,现场的人就会开始无视告警,这条线要盯死。
第二步,模型迭代闭环。试点跑顺了,把"边缘推理+云端训练"的回传链路打通。注意样本标注的人力:难例样本每天可能有几百张,得有人标注。我的做法是质检员顺手标——系统把低置信度的截图推到平板上,质检员点一下"对/错"就行,标注成本几乎为零。
第三步,复制推广。模型准确率稳定在 98% 以上、误报率低于 3%,再往别的线复制。这时候采购边缘盒子可以谈批量价,单台成本能再降 15%~20%。
还有个现实问题:老仓的网络改造。边缘方案对网络要求低,但不是没要求——相机到边缘盒子这段建议走有线,别图省事全用 Wi-Fi。一条线的布线成本几千美金,比起云端一年的带宽费,不值一提。
我的部署清单:三档分法
落地的时候别搞"一刀切",我一般按三档分:
第一档,纯边缘:视觉分拣、剔除、AMR 导航避障、PTL 灯光拣选的实时校验。这些装边缘盒子,断网可独立运行。硬件选型注意散热和防尘——仓库夏天 35 度以上很常见,消费级显卡扛不住,选工业级或至少是宽温的。
第二档,边缘推理+云端训练:这是最主流的做法。边缘跑推理,难例样本回传云端,云端重新训练后下发新模型。注意回传策略:别全量回传,只传"模型没把握"的样本(置信度低的),带宽省 90% 以上。
第三档,纯云端:需求预测、补货建议、经营分析看板、跨仓报表。这些对实时性没要求,云端的弹性算力和现成的数据工具反而是优势。
还有个运维细节:边缘盒子多了之后,模型版本管理会乱。一定要做远程 OTA 升级和版本回滚,别让工程师拿着 U 盘一台台去刷。我见过一个仓,12 台边缘盒子跑着 4 个不同版本的模型,排查问题查了一周。
最后给个明天就能用的动作:把你仓里在跑(或计划上)的 AI 场景列个表,按"延迟要求-推理频率-路数"三列打分。延迟要求 <100 毫秒的,直接划到边缘;频率低、路数少的,放云端。中间地带的,用"边缘推理+云端训练"的混合方案。这张表做完,供应商再跟你谈方案,你心里就有秤了。
你仓里现在跑的 AI,是部署在边缘还是云端?有没有被延迟坑过?评论区聊聊。
记住一句话:延迟敏感的放边缘,不赶时间的放云端,中间的用混合。架构选对了,AI 才是生产力;选错了,就是每个月准时到的账单。